ИИ для работы с документами: как выбрать инструмент под задачу
Практическое руководство: как выбрать ИИ для работы с документами, извлечь данные из договора, проверить результат и не отдать чувствительные файлы в публичный сервис.
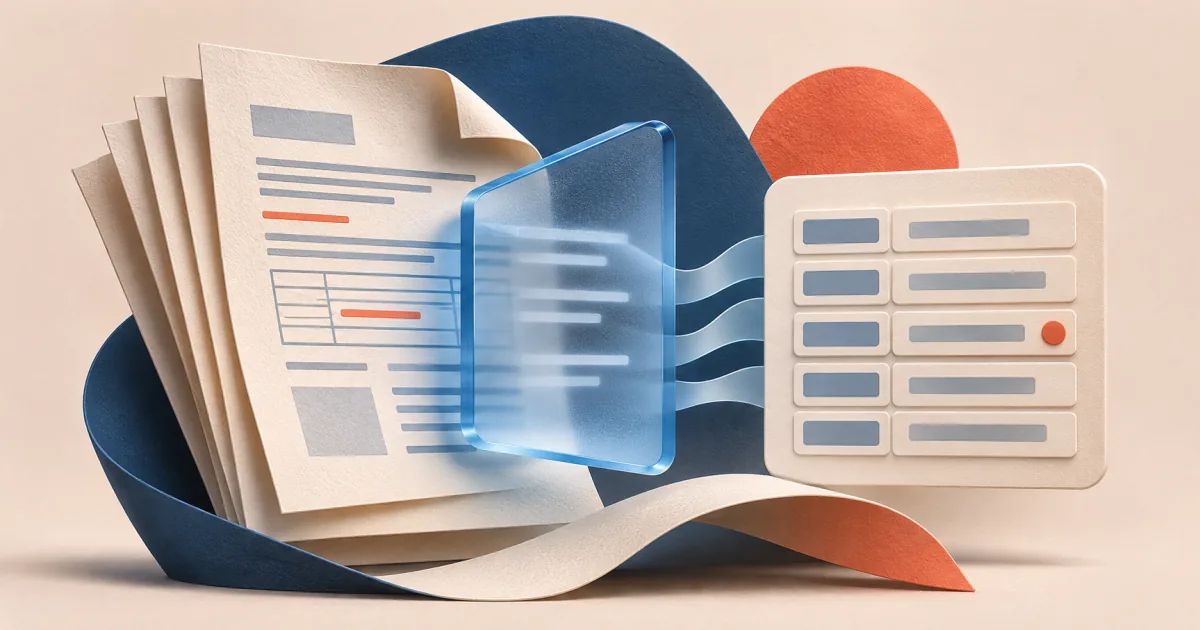
ИИ для документов полезен не «вообще», а под конкретную операцию: найти фрагмент в длинном PDF, вытащить поля из договора, сверить две версии, распознать скан. Универсальный чат-бот справится с текстовым файлом, но на плохом скане или таблице с числами ошибётся тихо. Поэтому выбирать стоит не «лучший сервис», а инструмент под тип файла и задачу — и заранее решить, что вы будете проверять вручную.
Четыре разные задачи, которые путают в одну
«Работа с документами» — слишком широкое понятие. От задачи зависит и инструмент, и способ проверки результата.
- Анализ и суммаризация. Нужно понять содержание: о чём отчёт, какие тезисы, где противоречия. Критично качество понимания текста и умение удерживать контекст длинного файла.
- Извлечение данных. Нужны конкретные поля: стороны, суммы, сроки, реквизиты. Критична точность на числах и датах, а не красивый пересказ.
- Проверка и сверка. Нужно найти расхождения между версиями или пропущенные пункты. Критична воспроизводимость: один и тот же запрос должен давать сопоставимый результат.
- Распознавание (OCR). Скан или фото нужно превратить в текст. Критична работа с плохим качеством изображения, рукописными пометками и сложной вёрсткой.
Если задача — извлечение полей из скана, сначала нужен OCR, а уже потом анализ. Загрузка мутного скана в чат-бот «напрямую» — частая причина неверных ответов.
Пять критериев выбора сервиса
Список сервисов быстро устаревает, а критерии — нет. Проверяйте инструмент по ним, а не по обещаниям на лендинге.
1. Тип файла и качество исходника
Текстовый PDF, скан, фото, таблица, презентация — разные форматы с разной устойчивостью к ошибкам. Для сканов ищите явное наличие OCR и тестируйте на своём худшем документе, а не на чистом примере.
2. Поддержка русского языка
Многие сервисы понимают запрос на русском, но качество работы с русскоязычным документом и с русской терминологией может отличаться. Проверяйте на своих формулировках, особенно если в документе юридическая или отраслевая лексика.
3. Лимиты и формат вывода
Ограничения на размер файла, число страниц и количество запросов влияют на реальную работу сильнее, чем «умность» модели. Отдельно смотрите, можно ли получить результат в структурированном виде (таблица, список полей), а не только абзацем текста.
4. Приватность и хранение данных
Ключевой критерий для договоров, персональных данных и внутренних регламентов. Уточняйте, где обрабатываются файлы, хранятся ли они, используются ли для обучения и можно ли удалить загруженное. Если ответа нет в документации — считайте риск нерешённым.
5. Цена и предсказуемость
Тарифы и лимиты меняются, поэтому фиксируйте для себя модель оплаты: за подписку, за страницы или за запросы. Для разовой задачи дорогая подписка не нужна, для потока документов важна предсказуемость стоимости.
Пример: извлечение полей из договора поставки
Допустим, есть договор поставки на несколько страниц, и нужно быстро вытащить ключевые условия для таблицы. Ниже — пример запроса, который задаёт структуру и требует опоры на текст. Это иллюстрация подхода, а не гарантия результата конкретного сервиса.
Ты помогаешь разобрать договор поставки.
Извлеки только те данные, которые прямо указаны в тексте.
Для каждого поля укажи значение, страницу и короткий фрагмент-подтверждение.
Если данных нет — напиши «не указано», не додумывай.

Поля:
1. Стороны (полное наименование)
2. Предмет договора
3. Срок действия
4. Общая сумма и валюта
5. Порядок оплаты
6. Ответственность сторон (штрафы, пени)
7. Порядок расторжения

Формат ответа — таблица: поле | значение | страница | подтверждение.
Что делать с результатом:
- Сверять каждое число и дату с исходником по указанной странице. Суммы, проценты и сроки — самое частое место ошибок.
- Проверять отрицательные ответы. «Не указано» может означать, что поле есть, но сформулировано иначе.
- Читать пункты об ответственности целиком. Краткая выжимка легко теряет условия, при которых штраф применяется или не применяется.
- Не переносить вывод в рабочий документ без вычитки. ИИ здесь — черновик разбора, а не финальное заключение.
Правило, которое экономит время: если сервис не может показать, откуда взято значение, считайте его непроверенным.
Матрица выбора: задача → тип файла → что критично
| Задача | Тип файла | Что критично в сервисе |
|---|---|---|
| Понять содержание отчёта | Текстовый PDF, DOCX | Работа с длинным контекстом, умение ссылаться на разделы |
| Извлечь поля договора | Текстовый PDF, DOCX | Структурированный вывод, цитаты и страницы, устойчивость к числам |
| Разобрать архив сканов | Скан, фото | Качество OCR, работа с вёрсткой и пометками |
| Сверить две версии | Любой текстовый | Воспроизводимость, аккуратная работа с формулировками |
| Разобрать таблицу | XLSX, CSV | Сохранение структуры, проверка чисел вручную |
Типичные ошибки и как их ловить
Плохой исходник
Мутный скан, косой снимок, рукописные правки — источник ошибок распознавания. Сначала проверьте, читается ли текст глазами; если нет, нужен OCR и ручная сверка, а не «умный» запрос.
Расплывчатый запрос
«Сделай краткое содержание» даёт разный результат при каждом повторе. Формулируйте задачу как список полей или вопросов и просите указывать место в документе.
Слепое доверие числам и пунктам
Модель может уверенно назвать номер пункта или сумму, которых в документе нет. Защита — требование цитаты и страницы плюс выборочная ручная проверка. Для юридически значимых выводов нужна отдельная экспертиза, а не ответ чат-бота.
Безопасность: что не стоит загружать в публичный сервис
Публичные чат-боты удобны, но не стоит отправлять туда документы с персональными данными, коммерческой тайной, платёжными реквизитами и внутренними регламентами без понимания политики хранения. Практичные шаги:
- Обезличивайте документы перед загрузкой, если это возможно.
- Проверяйте настройки хранения и удаления файлов.
- Для регулярной работы с чувствительными документами смотрите в сторону корпоративных решений с описанными условиями обработки данных — например, облачных платформ с документацией по обработке документов, таких как Google Document AI или Azure Document Intelligence. Возможности и тарифы этих сервисов нужно проверять в актуальной документации.
Чат-бот с файлом или специализированный сервис
Универсальный чат-бот удобен для разовых вопросов по тексту и быстрых черновиков. Специализированный сервис по документам обычно сильнее там, где нужны OCR, разметка полей, пакетная обработка и предсказуемый формат вывода. На практике часто работает связка: распознавание и извлечение — в специализированном инструменте, формулировки и объяснение — в чате. Подробнее о смежных подходах — в материалах об ИИ в анализе данных и об API для интеграции ИИ.
Чек-лист перед выбором сервиса
- Сформулируйте задачу одним предложением: анализ, извлечение, проверка или распознавание.
- Проверьте инструмент на своём худшем документе, а не на демо.
- Убедитесь, что результат можно сверить: есть цитаты, страницы или структурированный вывод.
- Уточните лимиты файлов и модель оплаты.
- Прочитайте, как обрабатываются и хранятся данные.
- Заранее решите, какие поля вы проверите вручную всегда.
ИИ ускоряет рутину, но ответственность за итоговый документ остаётся на человеке. Инструмент стоит выбирать под задачу и тип файла, а не по обещаниям «всё умеет».