RAG и архитектуры LLM-приложений: практический гайд
Практический разбор RAG и Agentic RAG: чанкинг, эмбеддинги, гибридный поиск, реранжирование, оценка качества и типичные ошибки архитектуры.
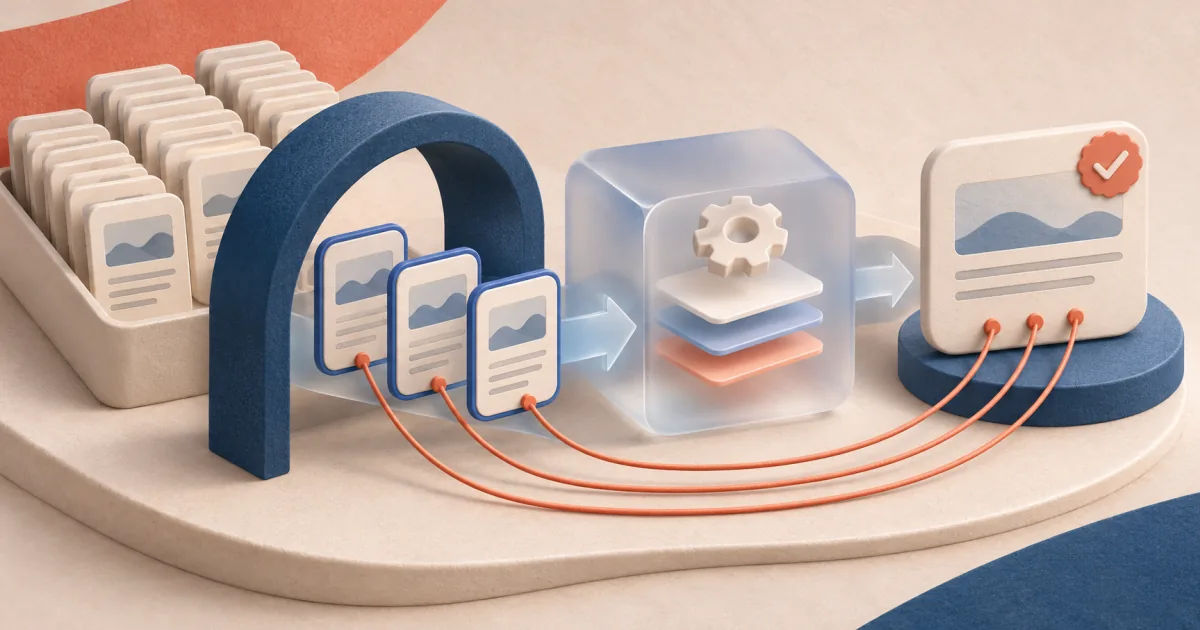
RAG (Retrieval-Augmented Generation) — подход, при котором языковая модель отвечает не только на основе своих весов, но и на основе фрагментов внешней базы знаний, найденных под конкретный запрос. Задача архитектора проста по формулировке и сложна в исполнении: собрать пайплайн так, чтобы модель получала релевантный и проверяемый контекст, а не случайные куски текста. Agentic RAG расширяет схему: поиск перестаёт быть одним проходом и превращается в управляемый цикл с планированием, вызовом инструментов и проверкой результата.
Ниже — разбор по шагам: индексация, чанкинг, эмбеддинги, гибридный поиск, реранжирование, оркестрация агентов, оценка качества и типичные ошибки. Сквозной пример — внутренний ассистент по тикетам и регламентам.
Базовый пайплайн RAG: индексация → извлечение → генерация
Классический RAG — линейная схема. Документы разбиваются на фрагменты, для них считаются векторные представления, фрагменты складываются в индекс. На запросе система ищет ближайшие фрагменты и передаёт их модели вместе с вопросом. Обзор Agentic RAG на arXiv (Agentic Retrieval-Augmented Generation: A Survey on Agentic RAG) описывает традиционные пайплайны как статические и линейные, что ограничивает многошаговые рассуждения и итеративное уточнение ответа. Обзор RAG для больших языковых моделей (Retrieval-Augmented Generation for Large Language Models: A Survey) относит к базовым компонентам извлечение, генерацию и приёмы дополнения контекста.
Три звена пайплайна отвечают за разные типы ошибок:
- Индексация — что вообще попало в базу и в каком виде.
- Извлечение — нашлись ли нужные фрагменты под запрос.
- Генерация — сумела ли модель корректно опереться на найденное.
Чанкинг: размер, перекрытие, разбиение по структуре
Чанкинг — первый источник скрытых проблем. Слишком крупный фрагмент размывает смысл: в него попадает несколько тем, и вектор перестаёт точно отражать нужную. Слишком мелкий теряет контекст: отдельная строка таблицы или пункт регламента без заголовка плохо интерпретируется и поиском, и моделью.
Практические ориентиры, которые стоит проверить на своём наборе:
- Разбивать по структуре документа (разделы, пункты, таблицы), а не только по длине.
- Добавлять к чанку метаданные: заголовок раздела, дату, тип документа, права доступа.
- Использовать перекрытие между соседними чанками, чтобы не терять смысл на границах.
- Хранить ссылку на исходный документ и позицию — это нужно и для цитирования, и для отладки.
Размер чанка не универсален: он зависит от плотности смысла в документах и от того, насколько длинные ответы ожидает пользователь. Проверять это нужно на размеченном наборе вопросов, а не на глаз.
Эмбеддинги и векторный индекс: что влияет на качество поиска
Модель эмбеддингов задаёт пространство, в котором измеряется близость запроса и фрагмента. На выбор влияют язык документов, доменная лексика, длина текста и ограничения по задержке. Универсальной модели «для всего» нет: пригодность конкретной модели под узкую терминологию проверяется сравнением на своих размеченных данных, а не по общим ожиданиям.
Отдельно стоит определиться с метрикой близости и нормализацией векторов: от этого зависит, как ранжируются результаты. Для векторного индекса важны не только качество, но и поведение при фильтрации по метаданным — например, когда нужно искать только в документах с определённым уровнем доступа.
Гибридный поиск и реранжирование
Векторный поиск хорошо ловит смысловую близость, но хуже работает с точными идентификаторами: кодами ошибок, артикулами, номерами пунктов, названиями систем. Полнотекстовый поиск, наоборот, точен по терминам, но не понимает перефразирования. Гибридная схема объединяет оба результата и часто даёт более устойчивое извлечение.
Когда нужен полнотекстовый поиск вместе с векторным
- В базе много кодов, артикулов, аббревиатур и точных названий.
- Пользователи формулируют запросы короткими техническими фразами.
- Нужно находить конкретный пункт регламента, а не общий смысл раздела.
Объединение результатов требует явной стратегии: взвешивание оценок, объединение рангов или отдельный этап слияния. Без этого гибрид может ухудшить выдачу, добавив шум.
Роль cross-encoder реранжирования
Первый этап поиска обычно использует bi-encoder: запрос и документ кодируются независимо, что позволяет быстро искать по индексу. Cross-encoder оценивает пару «запрос — фрагмент» совместно и точнее различает близкие варианты, но работает медленнее. Поэтому его ставят вторым этапом: сначала быстро отбирают кандидатов, затем переранжируют небольшой список.
Типичная ошибка — пропустить реранжирование при крупных чанках и большом индексе. В результате в контекст попадают фрагменты, лишь поверхностно связанные с вопросом, и модель отвечает уверенно, но неточно. Диагностируется это по метрикам извлечения, а не по тексту ответа.
RAG 2.0 и Agentic RAG: две разные оси
Эти термины часто смешивают. Полезно разделить их по двум осям.
Совместное обучение компонентов (RAG 2.0)
RAG 2.0 отвечает на вопрос, как обучены и согласованы компоненты системы: ретривер и языковая модель настраиваются совместно, а не по отдельности. В обзоре Agentic RAG на arXiv подход к эволюции парадигм RAG рассматривается как последовательность шагов от базовых схем к модульным и агентным, а согласование компонентов ради итогового качества — как отдельное архитектурное решение об обучении, а не о том, как управляется поиск во время запроса.
Управление поиском циклом (Agentic RAG)
Что такое Agentic RAG: это схема, в которой языковая модель выступает оркестратором и сама решает, когда искать, как переформулировать запрос, какой инструмент вызвать и достаточно ли собранных данных. Обзор на arXiv относит к агентным паттернам рефлексию, планирование, использование инструментов и мультиагентную коллаборацию. Ключевое отличие от классического RAG — итеративность и явный слой управления.
Agentic RAG архитектура не требует совместного обучения компонентов, а RAG 2.0 не обязательно включает агентный цикл. Подходы не исключают друг друга, но выбирать их стоит по разным критериям: RAG 2.0 — это инвестиция в обучение, Agentic RAG — инвестиция в оркестрацию и надёжность.
Сквозной пример: ассистент по тикетам и регламентам
Допустим, есть внутренняя база: регламенты поддержки, инструкции по настройке, история закрытых тикетов. Ассистент должен отвечать сотрудникам и ссылаться на источник.
Классический RAG на простом фактологическом вопросе
Вопрос: «Какое время реакции по тикетам приоритета P2?» Это одношаговый фактологический запрос. Пайплайн: векторный поиск находит пункт регламента, реранжирование отсекает похожие пункты про P1 и P3, модель отвечает с указанием раздела. Здесь классической схемы достаточно, а агентный цикл добавит задержку без пользы.
Многошаговый вопрос и переход к агентному циклу
Вопрос: «Почему за последний квартал выросло среднее время закрытия P2-тикетов и что об этом говорит регламент?» Здесь нужны данные из тикетов, сравнение периодов и сверка с нормативным документом. Классический RAG найдёт фрагменты, но не сможет сопоставить их между собой.
Агентный цикл в этом случае выглядит так:
- Планирование: разбить вопрос на подзадачи — метрики по тикетам, изменения в регламенте, возможные причины.
- Выбор инструментов: запрос к аналитике тикетов, поиск по регламентам, поиск по истории похожих инцидентов.
- Извлечение и оценка: проверить, что найденные фрагменты относятся к нужному периоду и приоритету.
- Итерация: если данных о причинах недостаточно, переформулировать запрос или обратиться к другому источнику.
- Генерация: собрать ответ со ссылками на источники и явно указать, где данных не хватило.
Точки отказа в этом примере: устаревший регламент в индексе, разные определения приоритетов в тикетах и документах, отсутствие ограничения на число итераций. Каждая из них диагностируется отдельно — на уровне извлечения, данных или оркестрации.
Учебный пример разметки для проверки извлечения
Учебный, вымышленный набор из пяти вопросов к внутренней базе показывает, как устроить проверку извлечения до того, как смотреть на ответы модели. Для каждого вопроса вручную отмечают фрагмент-эталон, который обязан попасть в выдачу.
Условная разметка (все значения вымышленные, только для иллюстрации метода):
- Вопрос 1 — эталон найден на позиции 1.
- Вопрос 2 — эталон найден на позиции 3.
- Вопрос 3 — эталон найден на позиции 2.
- Вопрос 4 — эталон не попал в первые пять результатов.
- Вопрос 5 — эталон найден на позиции 1.
Если считать recall@3 — долю вопросов, где эталон оказался среди первых трёх результатов, — то в учебном примере это 4 из 5: вопросы 1, 2, 3 и 5. Вопрос 4 выпадает, и именно его разбирают первым: смотрят, как документ был нарезан на чанки, не потерялся ли заголовок раздела, не расходится ли формулировка в документе с формулировкой вопроса. Такой прогон отделяет проблему извлечения от проблемы генерации: пока recall низкий, менять промпт модели бессмысленно.
Оценка качества: retrieval-метрики и метрики ответа
Оценивать RAG только по ответам недостаточно: непонятно, где именно произошла ошибка. Нужны две группы метрик.
| Группа | Что показывает | Как считать |
|---|---|---|
| Retrieval | Попал ли нужный фрагмент в выдачу | Разметить набор вопросов эталонными фрагментами и считать recall@k и точность попадания |
| Answer | Корректен ли итоговый ответ | Сравнить с эталонным ответом или оценить экспертом по критериям |
Recall@k показывает долю вопросов, для которых правильный фрагмент оказался среди первых k результатов. Если recall низкий, проблема в индексации, чанкинге или поиске — менять промпт бесполезно. Если recall высокий, а ответы неверные, смотреть стоит на генерацию и на то, как модель использует контекст. Абсолютные значения метрик зависят от набора данных и разметки, поэтому сравнивать имеет смысл только замеры на одном и том же наборе.
Для агентных схем добавляются метрики процесса: число итераций, доля запросов, завершившихся без ответа, расход токенов и задержка. Без них агентный цикл легко становится дорогим и непредсказуемым.
Типичные ошибки и как их диагностировать
- Крупные чанки без реранжирования. Симптом: ответы звучат уверенно, но опираются на соседнюю тему. Проверка: recall@k и ручной разбор выдачи.
- Игнорирование точных терминов. Симптом: коды и артикулы не находятся. Проверка: отдельный набор запросов с идентификаторами, сравнение векторного и гибридного поиска.
- Отсутствие метаданных. Симптом: в контекст попадают устаревшие или недоступные документы. Проверка: фильтрация по дате и правам доступа.
- Бесконечный агентный цикл. Симптом: рост задержки и расхода токенов без улучшения ответа. Проверка: лимит итераций и логирование шагов.
- Оценка только по ответам. Симптом: непонятно, что чинить. Проверка: раздельные retrieval- и answer-метрики.
Критерии выбора архитектуры под задачу
| Критерий | Классический RAG | Agentic RAG |
|---|---|---|
| Тип вопросов | Фактологические, одношаговые | Многошаговые, требующие сопоставления источников |
| Число источников | Один-два | Несколько, включая инструменты и API |
| Допустимая задержка | Низкая | Выше, зависит от числа итераций |
| Расход токенов | Предсказуемый | Растёт с каждой итерацией |
| Требования к проверяемости | Ссылки на фрагменты | Ссылки плюс логи шагов и инструментов |
Начинать почти всегда стоит с классического RAG и гибридного поиска с реранжированием: это дешевле и проще в отладке. Агентный слой оправдан, когда вопросы действительно многошаговые, а ошибки из-за неполного контекста дороги. RAG 2.0 — отдельное решение об обучении, которое имеет смысл только при наличии данных и ресурсов для совместной настройки компонентов.
Итоги
Качество RAG-приложения определяется не моделью, а дисциплиной пайплайна: структурой чанков, качеством эмбеддингов, гибридным поиском, реранжированием и раздельной оценкой извлечения и ответа. Agentic RAG добавляет управляемый цикл и инструменты, но вместе с ним — задержку, расход токенов и новые точки отказа. Разделение RAG 2.0 и Agentic RAG по двум осям помогает не смешивать обучение компонентов с оркестрацией поиска и выбирать архитектуру под конкретную задачу, а не по названию.
Смежные материалы по теме: нейросети для обработки текста и работа с NLP и как избежать ошибок при работе с генеративными моделями.
Источники
Терминология и ссылки актуальны на момент публикации материала.